
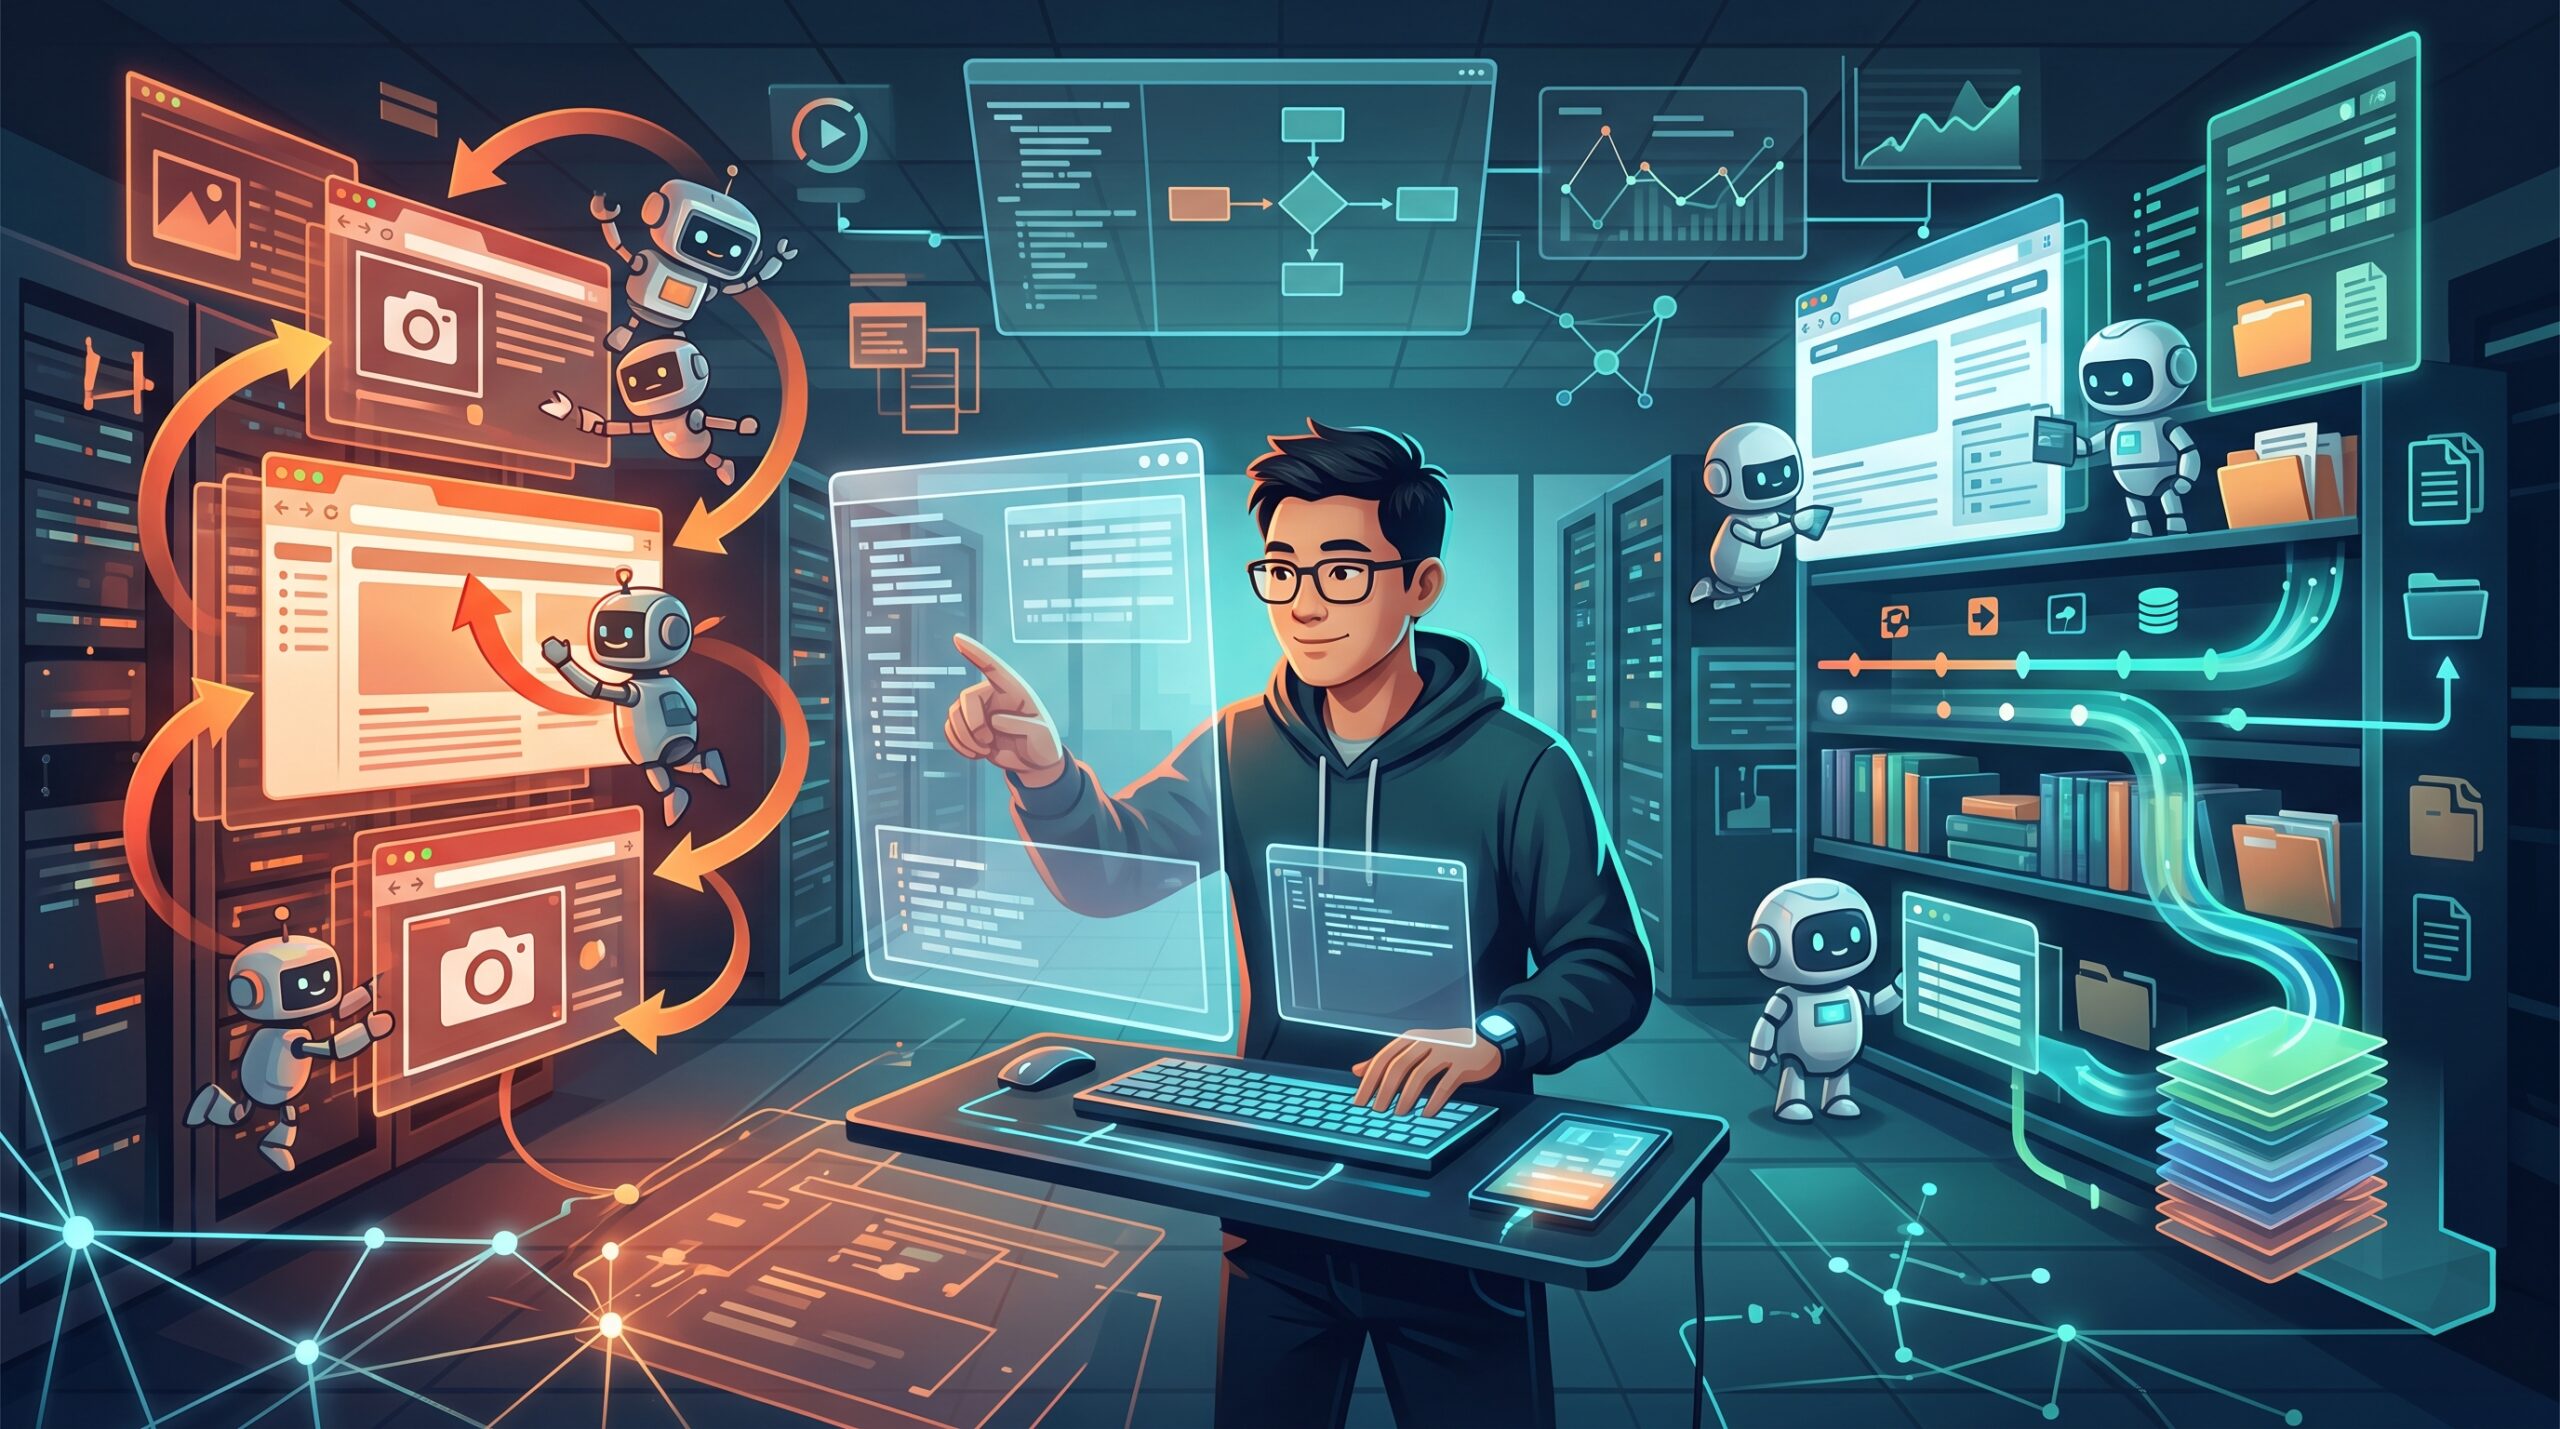
Asana ha annunciato che, nei test di un’IA che automatizza le operazioni nel browser di StackAI, ha ridotto a un settantaseiesimo il costo stimato del modello rispetto alla configurazione di produzione precedente, aumentando la velocità di elaborazione di 5 volte. Con una configurazione ottimizzata, basata su GPT‑6.1 Sol e sulla gestione della cronologia di navigazione, ogni elaborazione è costata in media 0,47 dollari ed è durata circa 4 minuti.
Ridurre i costi a un settantaseiesimo non è stato solo merito del cambio di modello
Il dato da tenere presente è che il confronto non riguarda le prestazioni del solo modello, ma il risultato ottenuto combinando il modello con il processo di elaborazione. Un agente per il browser è un’IA che legge le pagine web e svolge attività come raccogliere informazioni o compilare moduli. Asana offre l’automazione di queste attività tramite StackAI, acquisita dall’azienda.
Nel test sono state raccolte sei informazioni per ciascuno di 32 libri presenti in un catalogo di demo pubbliche. Sono state effettuate 144 prove in totale, con quattro modelli e diverse configurazioni. Con il modello B, usato inizialmente, il costo stimato per ogni elaborazione era di almeno 36,21 dollari, ma è sceso a 1,24 dollari semplicemente rivedendo il processo di elaborazione. Con la configurazione ottimizzata basata su GPT‑6.1 Sol, è sceso ulteriormente a 0,47 dollari.
In altre parole, mantenendo il modello B si è riusciti comunque a ridurre i costi a circa un ventinovesimo. Dietro al dato del settantaseiesimo c’è stato un importante miglioramento della progettazione del processo, precedente alla scelta del modello.
La chiave del risparmio era la cronologia di navigazione fornita all’IA
Nella configurazione precedente, venivano memorizzate nella cache le istruzioni fisse e altri elementi, ma non la cronologia accumulata di contenuti delle pagine e screenshot. La cache è un meccanismo che consente di riutilizzare input già elaborati. Se la cronologia non può essere riutilizzata, a ogni chiamata all’IA occorre reinviare le informazioni precedenti, con i relativi costi.
Inoltre, quasi a ogni passaggio venivano eliminate le immagini meno recenti e accorciati i testi. Poiché la cronologia veniva modificata di frequente, la sola introduzione della cache difficilmente avrebbe prodotto risultati. Eliminare troppe informazioni può anche costringere a visitare di nuovo pagine già lette.
Per questo il limite di conservazione della cronologia è stato aumentato da 120.000 a 480.000 caratteri e la cronologia di navigazione è stata inclusa nella cache. Gli screenshot vengono accumulati fino a 20, dopodiché si conserva solo il più recente. Anziché riordinare tutto a ogni passaggio, l’organizzazione avviene in blocco, prolungando il periodo durante il quale è possibile riutilizzare la cronologia passata senza modificarla.
Anche conservando più informazioni si possono ridurre i costi
Meno informazioni si forniscono all’IA, meno si spende. I risultati di questo test mostrano che questo principio, da solo, non basta a spiegare i costi degli agenti. Conservare e riutilizzare le informazioni, riducendo le verifiche inutili, può costare meno nell’elaborazione complessiva.
Con GPT‑6.1 Sol, rivedendo la cache e la gestione delle immagini dopo aver ampliato il limite di conservazione della cronologia, il costo stimato per ogni elaborazione è sceso da 1,97 a 0,47 dollari. Dopo l’ottimizzazione, l’89% degli input proveniva dalla cache e il costo di quella parte era pari al 5% di quello previsto senza cache.
La quantità di cronologia influisce anche sul completamento delle attività. Con GPT‑6.1 Sol, nelle condizioni con un limite di conservazione inferiore sono state generate risposte in 3 casi su 18, mentre con il limite più ampio è successo in tutti e 18 i casi. Nel test, tutte e 18 le risposte erano corrette.
Anche per provare le proposte di miglioramento è stata usata l’IA
A occuparsi della ricerca e dei miglioramenti è stato GPT‑6 Astra di Codex, distinto da GPT‑6.1 Sol, che eseguiva le operazioni nel browser. Ha esaminato la struttura del codice, individuato i problemi nella gestione della cronologia, riorganizzato il codice per gli esperimenti e verificato in parallelo diverse configurazioni.
Non è mancato il coinvolgimento umano. Frank Hidalgo, CTO di StackAI, ha esaminato le proposte e selezionato le modifiche da testare. I registri degli esperimenti e i risultati sono stati revisionati anche in altre sessioni del modello e conservati in Command, la piattaforma di sviluppo di Asana. Le modifiche sono state portate in produzione tramite ticket e pull request.
Hidalgo ha spiegato che un’attività di ricerca che, a suo avviso, avrebbe richiesto da 1 a 2 mesi di lavoro manuale è stata completata in circa una settimana. Il confronto temporale si basa sulla sua stima e non sui risultati di un esperimento di controllo in cui lo stesso lavoro sia stato svolto esclusivamente da persone.
Per decidere se adottarla, occorre valutare insieme i costi e il tasso di completamento
Il dato di 0,47 dollari rappresenta il costo stimato del modello, non il costo totale, che comprenderebbe anche il personale e la gestione del sistema. Inoltre, alcuni dei casi usati come riferimento per il confronto non sono stati completati perché avevano raggiunto il limite di iterazioni; di conseguenza, i valori di almeno 36,21 dollari e almeno 22,5 minuti sono soglie minime. I principali valori di confronto sono medie basate su tre esecuzioni per configurazione e non è possibile applicare la stessa percentuale di riduzione a tutte le attività sul web.
Tra le configurazioni ottimizzate, il modello C ha registrato 0,66 dollari e 3,5 minuti, mentre GPT‑6.1 Sol ha registrato 0,47 dollari e circa 4 minuti. In questa attività Sol è risultato meno costoso, ma il modello C è stato più rapido: i due modelli si classificano diversamente per costo e velocità.
Asana ha applicato queste modifiche alla funzione di controllo del browser di StackAI. In futuro intende integrare i test nelle funzionalità di valutazione della piattaforma, così che clienti e team interni possano confrontare, per ciascuna configurazione, costi, tempi di esecuzione e qualità delle risposte.

コメント