
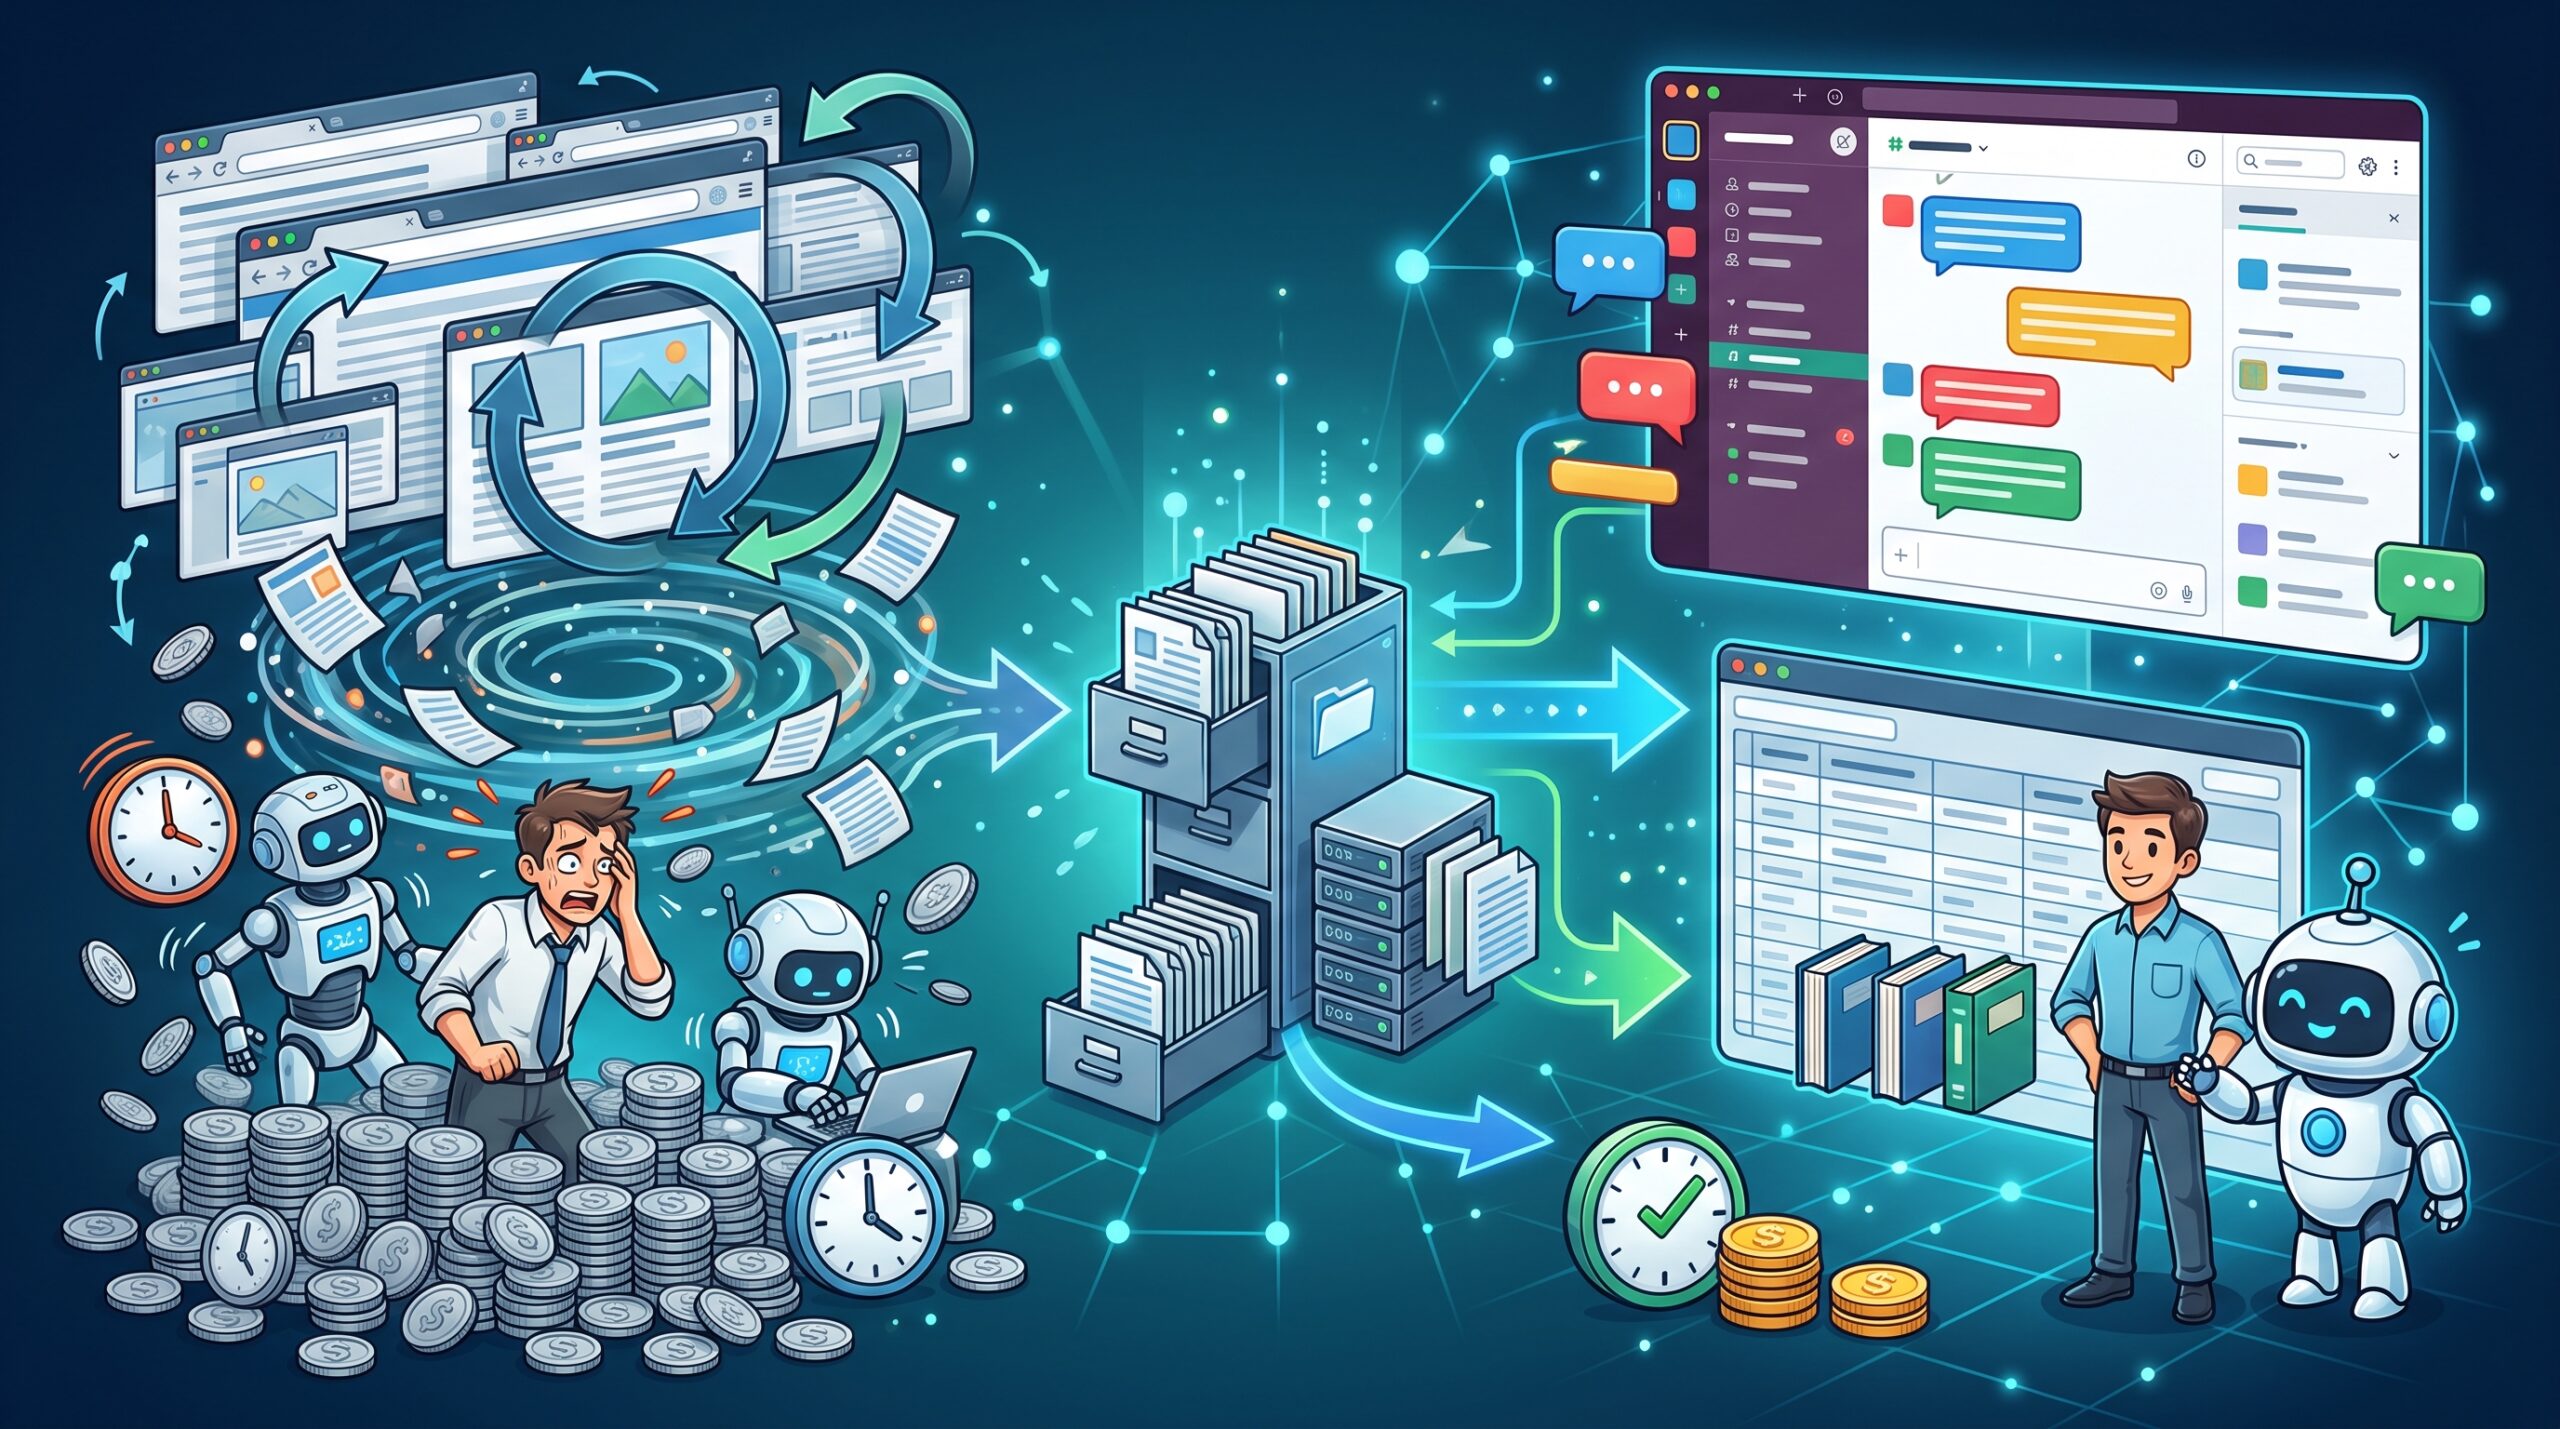
Asana a annoncé qu’une configuration utilisant GPT‑6.1 Sol avait ramené le coût estimé des modèles à une moyenne de 0,47 dollar par exécution, pour une durée d’environ 4 minutes, lors d’une évaluation visant à optimiser l’IA de navigation web de StackAI. Par rapport à la configuration initiale en production, le coût a été divisé par environ 76 et le traitement a été environ cinq fois plus rapide.
La réduction par 76 ne tient pas au seul changement de modèle
Ouvrir une page web, y trouver les informations nécessaires, remplir un formulaire : les agents de navigation web qui effectuent ce type d’opérations pour le compte de l’utilisateur font appel au modèle à plusieurs reprises pendant leur travail, contrairement à une IA qui génère une réponse en une seule fois. Chez StackAI, racheté par Asana, les clients peuvent concevoir sans écrire de code des séquences d’automatisation faisant intervenir plusieurs applications métier.
Il faut retenir de ces chiffres que la réduction d’environ 76 fois résulte à la fois de l’amélioration du processus et du changement de modèle. Avec le modèle B utilisé au départ, l’optimisation a déjà ramené le coût estimé par exécution de plus de 36,21 dollars à 1,24 dollar. L’utilisation de GPT‑6.1 Sol l’a ensuite fait passer à 0,47 dollar. Une grande partie de la réduction avait donc été obtenue avant le changement de modèle.
Par ailleurs, le coût évoqué ici est une estimation des frais d’utilisation des modèles. Cela ne signifie pas que le coût total, incluant les frais de serveur ainsi que les coûts de main-d’œuvre liés au développement et à l’exploitation, a diminué dans la même proportion.
Si l’IA conserve trop peu d’historique, elle relit les mêmes pages
Frank Hidalgo, directeur technique de StackAI, qui a mené l’étude, a demandé à GPT‑6 Astra de Codex d’analyser le code et de tester des pistes d’amélioration. L’un des problèmes relevés était que le contenu des pages et l’historique des captures d’écran étaient renvoyés au modèle à chaque requête. Les instructions fixes et d’autres éléments pouvaient être réutilisés, mais le même mécanisme n’était pas appliqué à l’historique de navigation, qui ne cessait de s’allonger.
De plus, les anciennes images étaient supprimées et le texte tronqué presque à chaque étape. La réécriture fréquente de l’historique rend le cache moins efficace : celui-ci permet de réutiliser des entrées déjà traitées et de réduire les frais. Si trop d’informations sont supprimées, l’IA risque aussi de revenir sur des pages qu’elle a déjà lues. La structure était telle que les efforts visant à raccourcir les entrées pouvaient, paradoxalement, accroître le travail.
Ne pas supprimer les images à chaque fois : attendre d’en avoir 20 pour faire le tri
Lors de l’évaluation, la limite de conservation de l’historique a été fixée à 120 000 ou 480 000 caractères, et les règles de gestion du cache et des images ont été modifiées. Au total, 144 exécutions ont été réalisées avec quatre modèles. La tâche était la même pour tous : recueillir six informations sur chacun des 32 livres figurant dans un catalogue de démonstration public.
La configuration optimisée de GPT‑6.1 Sol conservait jusqu’à 20 captures d’écran, puis n’en gardait que la plus récente. En les triant par lots plutôt qu’en supprimant les images à chaque fois, elle prolongeait la période pendant laquelle l’historique pouvait être réutilisé sans modification.
Même en ne comparant que GPT‑6.1 Sol, la révision du cache et de la gestion des images, avec une limite de conservation de l’historique plus élevée, a fait passer le coût estimé des modèles de 1,97 à 0,47 dollar. Après optimisation, 89 % des entrées ont été traitées via le cache, au tarif de 5 % de celui des entrées ordinaires. L’efficacité vient donc de la conception qui facilite la réutilisation des informations conservées, et non du simple fait d’en réduire la quantité.
Le taux de réussite a lui aussi évolué, pas seulement le coût
La gestion de l’historique a également eu une incidence sur la capacité à terminer les tâches. Avec GPT‑6.1 Sol, une réponse a pu être générée lors de seulement 3 des 18 exécutions lorsque la limite de conservation était faible. Avec une limite plus élevée, une réponse a été générée lors des 18 exécutions, et les résultats étaient tous corrects, selon Asana.
Il convient toutefois de nuancer la comparaison faisant état d’une réduction par environ 76 et d’une exécution environ cinq fois plus rapide. Dans la configuration initiale, certaines exécutions avaient atteint la limite du nombre d’étapes avant d’être terminées ; les valeurs de plus de 36,21 dollars et de plus de 22,5 minutes correspondent donc à des minima. Les principales valeurs comparées sont également des moyennes de trois exécutions par configuration et proviennent de la tâche de collecte d’informations décrite ici. On ne peut pas en conclure que les réductions seront identiques sur d’autres sites ou pour d’autres tâches professionnelles.
Les modèles ont aussi des atouts différents. Après optimisation, le modèle C a coûté 0,66 dollar et pris 3,5 minutes : il était plus cher que GPT‑6.1 Sol, à 0,47 dollar et environ 4 minutes, mais plus rapide. Lors du déploiement, il faut donc comparer séparément le coût et la vitesse.
L’IA mène les expériences, les humains vérifient les modifications
Dans ce cas, GPT‑6 Astra ne s’est pas contenté de proposer des améliorations : il a aussi modifié le code pour harmoniser les conditions expérimentales et exécuté les vérifications. Une autre session de modèle a examiné le travail, et les requêtes comme les résultats ont été consignés dans Command, la plateforme de développement d’Asana. Selon Hidalgo, une étude qu’il aurait estimé devoir prendre un à deux mois à la main a été achevée en environ une semaine. Cette différence de durée est une estimation de sa part, et non le résultat d’une comparaison expérimentale avec un travail effectué par des humains.
Ce cas montre que, pour évaluer les coûts d’exploitation de l’IA, il existe autant de marge d’analyse dans la manière dont les appels sont effectués et dont l’historique est conservé que dans le prix unitaire des modèles. Asana a intégré ces changements à la fonctionnalité de navigation web de StackAI. L’entreprise prévoit d’ajouter des tests à ses fonctions d’évaluation afin que ses clients et ses équipes internes puissent comparer, selon les paramètres choisis, le coût, la durée d’exécution et la qualité des réponses.

コメント