
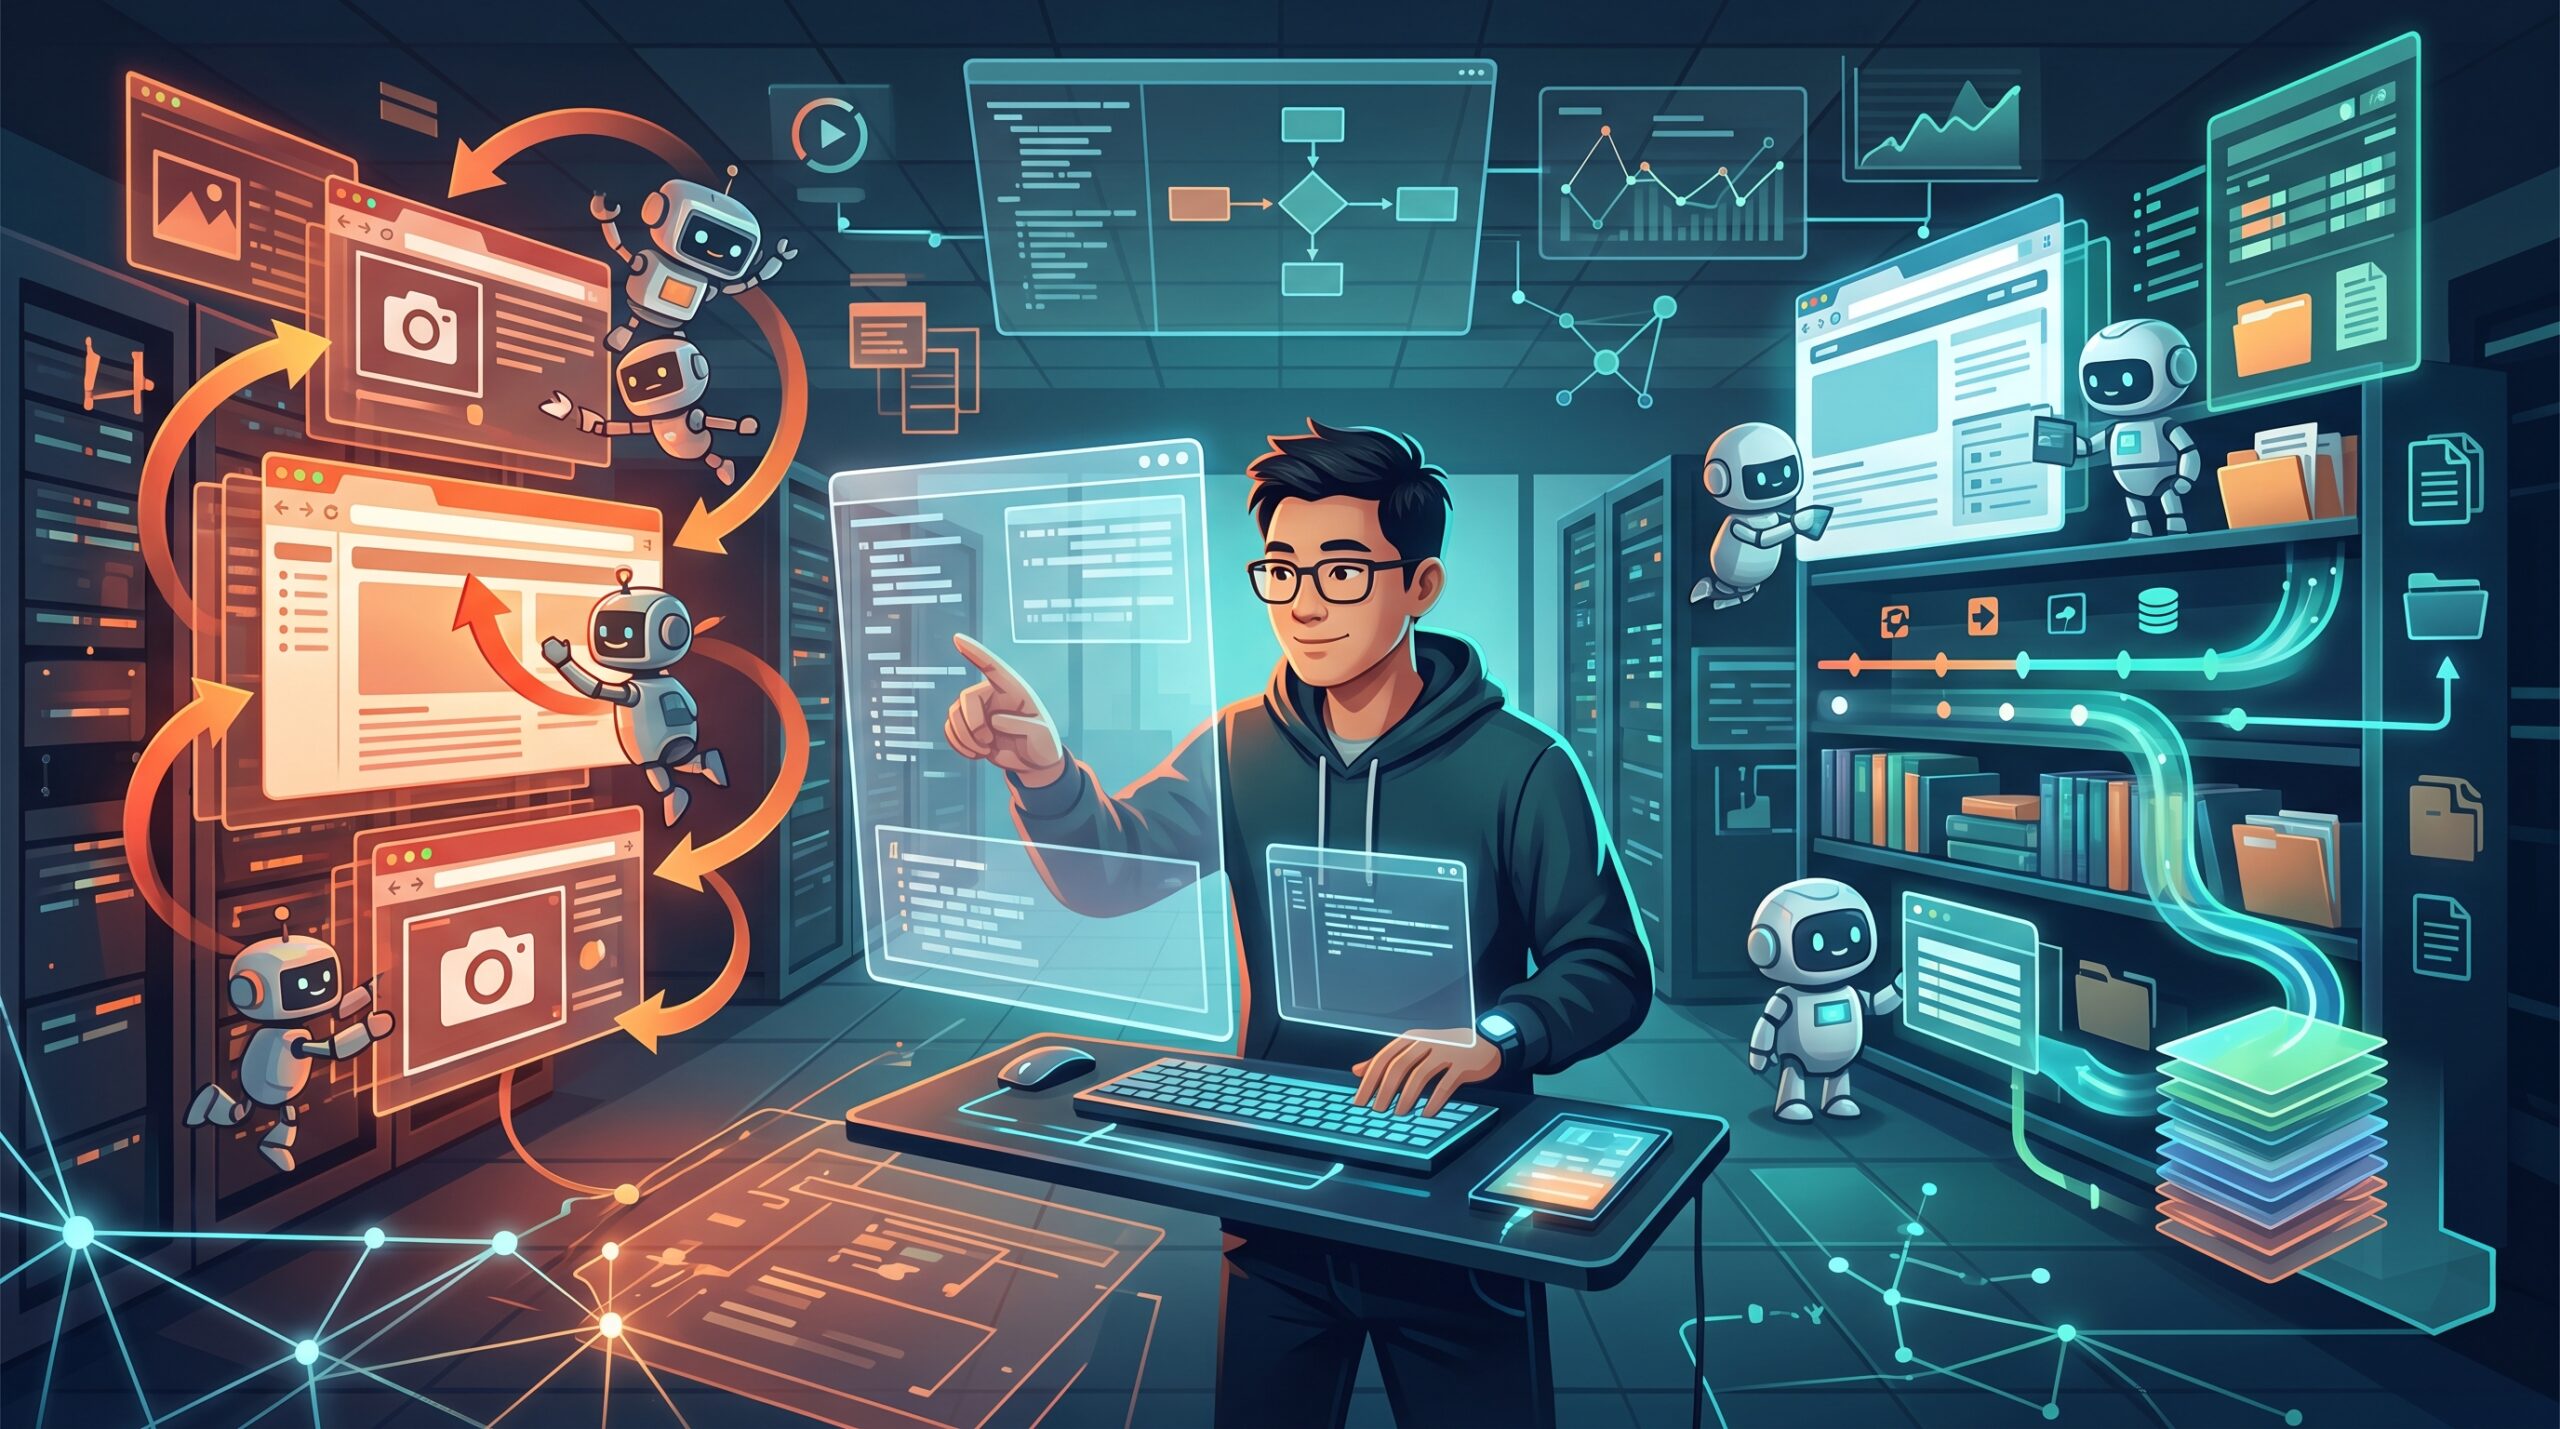
Asana anunció que, en una evaluación de la IA de StackAI que automatiza operaciones en el navegador, redujo a una setentaiseisava parte el coste estimado de los modelos y multiplicó por cinco la velocidad de procesamiento frente a la configuración de producción anterior. Con una configuración optimizada que utiliza GPT‑6.1 Sol y gestiona mejor el historial de navegación, cada ejecución costó una media de 0,47 dólares y duró unos 4 minutos.
Reducir el coste a una setentaiseisava parte no se logró solo cambiando de modelo
Lo importante de estas cifras es que no comparan el rendimiento de los modelos por separado, sino el resultado de combinar un modelo con un sistema de procesamiento. Un agente de navegador es una IA que lee páginas web y realiza tareas como recopilar información o rellenar formularios. Asana ofrece la automatización de este tipo de tareas a través de StackAI, empresa que adquirió.
En la evaluación se recopilaron seis datos de cada uno de 32 libros del catálogo de demostraciones públicas. Se hicieron 144 pruebas con cuatro modelos y varias configuraciones. Con el modelo B, utilizado inicialmente, el coste estimado de cada ejecución era de al menos 36,21 dólares, pero bastó con revisar el sistema de procesamiento para reducirlo a 1,24 dólares. Con la configuración optimizada que utiliza GPT‑6.1 Sol, bajó aún más, hasta 0,47 dólares.
Es decir, incluso manteniendo el modelo B, el coste se redujo a aproximadamente una vigesimonovena parte. Detrás del titular sobre la reducción a una setentaiseisava parte, la mejora del diseño del procesamiento antes de elegir el modelo desempeñó un papel fundamental.
La clave del ahorro estaba en el historial de navegación que se proporciona a la IA
En la configuración anterior se almacenaban en caché las instrucciones fijas, entre otros elementos, pero no el contenido de las páginas acumulado ni el historial de capturas de pantalla. La caché es un sistema que permite reutilizar entradas ya procesadas. Si no se puede reutilizar el historial, hay que volver a enviar la información anterior cada vez que se invoca la IA, lo que genera un coste adicional.
Además, casi en cada paso se borraban las imágenes antiguas y se acortaban los textos. Como el historial se modificaba con frecuencia, añadir una caché por sí solo difícilmente habría dado resultado. Borrar demasiada información también puede hacer que se vuelvan a visitar páginas ya consultadas.
Por ello, el límite de almacenamiento del historial se amplió de 120.000 a 480.000 caracteres y se incluyó el historial de navegación en la caché. Se optó por acumular hasta 20 capturas de pantalla y conservar únicamente la más reciente. En lugar de reorganizar el historial en cada ocasión, se hizo de forma agrupada, lo que permitió mantenerlo sin cambios durante más tiempo y reutilizarlo.
Conservar más información también puede reducir los costes
Reducir la información que se proporciona a la IA abarata el proceso. Sin embargo, los resultados de esta evaluación muestran que esta idea, por sí sola, no basta para explicar el coste de los agentes. En algunos casos, conservar y reutilizar la información y evitar comprobaciones innecesarias puede abaratar el procesamiento en su conjunto.
Con GPT‑6.1 Sol, al revisar la caché y la gestión de imágenes bajo las condiciones que ampliaban el límite de almacenamiento del historial, el coste estimado por ejecución bajó de 1,97 a 0,47 dólares. Tras la optimización, el 89 % de las entradas procedía de la caché, y la tarifa de esa parte equivalía al 5 % de lo que habría costado sin utilizarla.
La cantidad de historial también influye en la finalización de las tareas. Con GPT‑6.1 Sol, se pudieron generar respuestas en 3 de 18 ejecuciones cuando el límite de almacenamiento era menor, frente a las 18 de 18 cuando era mayor. En la evaluación, las 18 respuestas fueron correctas.
También se utilizó IA para probar las mejoras propuestas
Para investigar y mejorar el sistema se utilizó GPT‑6 Astra de Codex, distinto de GPT‑6.1 Sol, que es el que opera el navegador. GPT‑6 Astra analizó la estructura del código, identificó problemas en la gestión del historial, reorganizó el código para los experimentos y probó en paralelo varias configuraciones.
Eso no significa que no intervinieran personas. Frank Hidalgo, CTO de StackAI, revisó las propuestas y seleccionó las modificaciones que debían probarse. Los registros y resultados de los experimentos también se revisaron en otra sesión de modelo y se guardaron en Command, la plataforma de desarrollo de Asana. Los cambios se llevaron a producción mediante tickets y solicitudes de incorporación de cambios.
Hidalgo explicó que una investigación que, a mano, habría llevado entre uno y dos meses se completó en aproximadamente una semana. La diferencia de tiempo es una estimación suya y no el resultado de una prueba de control en la que personas realizaran por sí solas el mismo trabajo.
Para decidir si se implanta, hay que valorar conjuntamente el coste y la tasa de finalización
Los 0,47 dólares corresponden al coste estimado de los modelos, no al coste total, que incluiría la mano de obra y la operación del sistema. Además, algunas de las configuraciones de referencia alcanzaron el límite de ejecuciones sin completar la tarea, por lo que las cifras de al menos 36,21 dólares y 22,5 minutos son valores mínimos. Las principales cifras comparativas son promedios de tres ejecuciones por configuración; no se puede aplicar el mismo porcentaje de reducción a todas las tareas web.
Entre las configuraciones optimizadas, el modelo C costó 0,66 dólares y tardó 3,5 minutos, mientras que GPT‑6.1 Sol costó 0,47 dólares y tardó unos 4 minutos. En esta tarea, Sol fue más barato, pero el modelo C fue más rápido: el orden cambia según se valore el coste o la velocidad.
Asana ya ha incorporado estos cambios a la función de navegación de StackAI. La empresa prevé integrar las evaluaciones en las funciones de evaluación de la plataforma para que clientes y equipos internos puedan comparar el coste, el tiempo de ejecución y la calidad de las respuestas de cada configuración.

コメント