
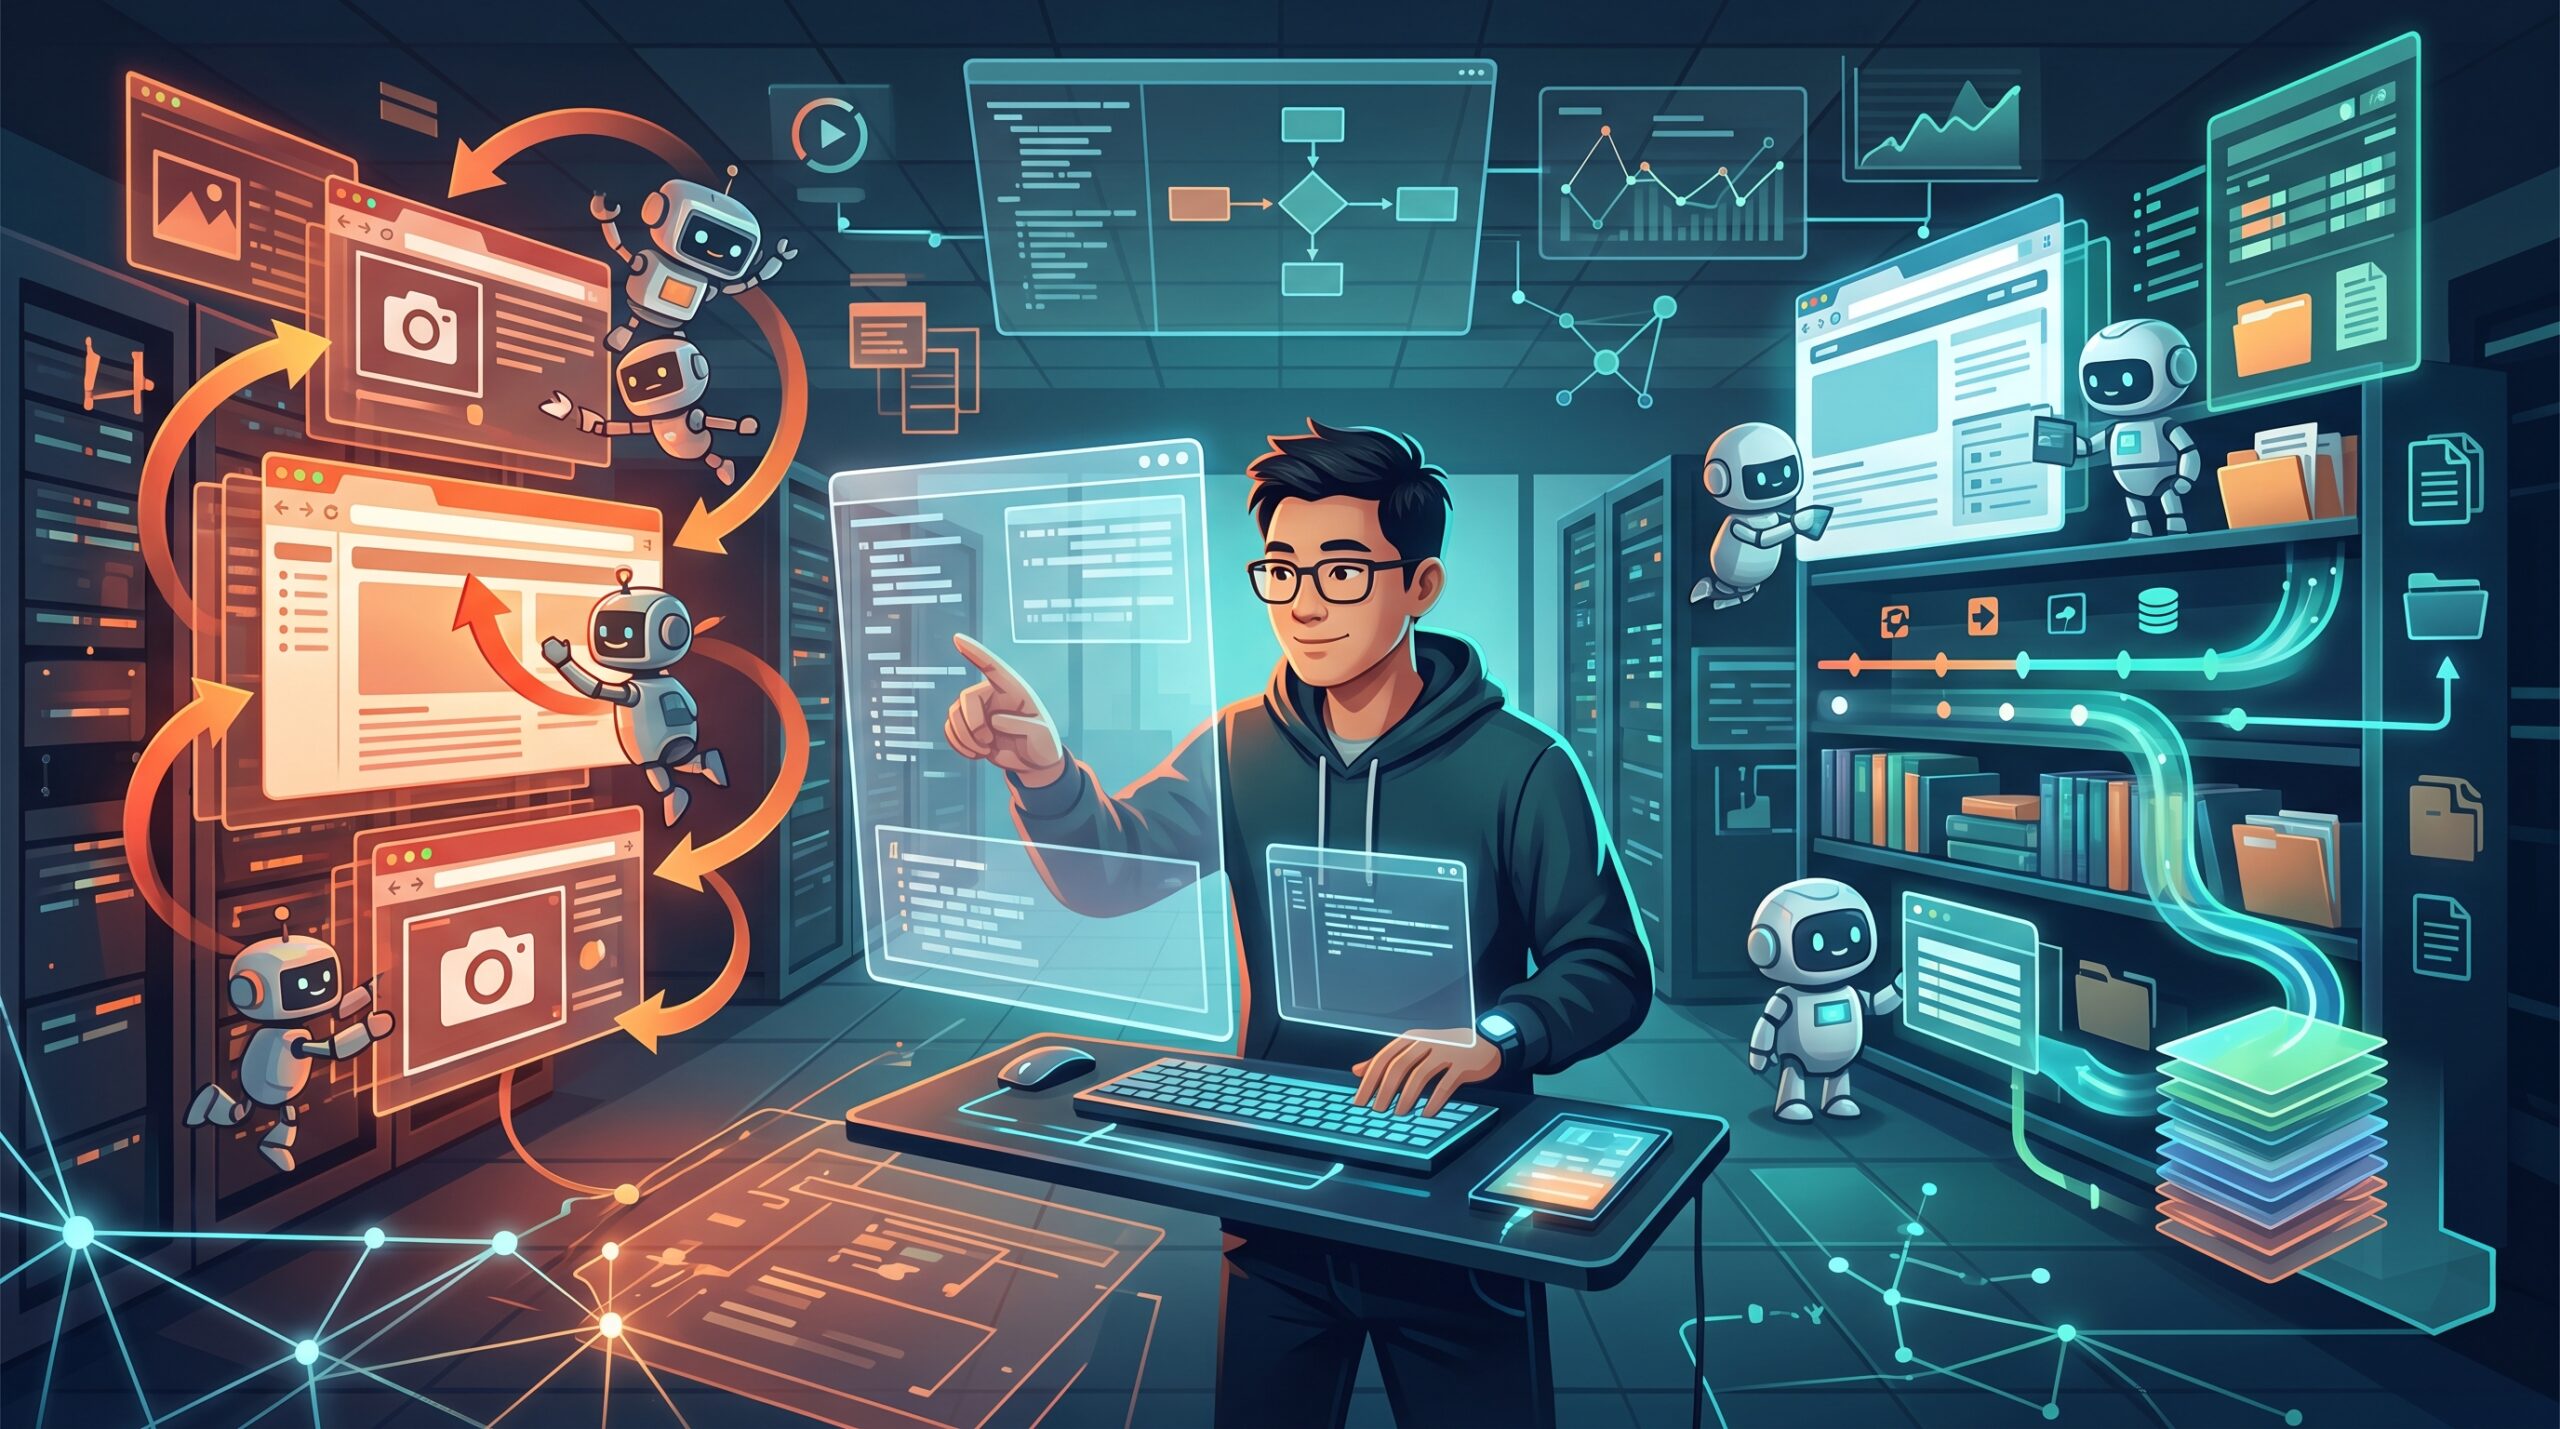
Asana a annoncé que, lors d’un test de son IA automatisant les interactions avec le navigateur de StackAI, le coût estimé des modèles avait été divisé par 76 et la vitesse de traitement multipliée par cinq par rapport à la configuration de production précédente. Avec GPT‑6.1 Sol et une gestion optimisée de l’historique de navigation, chaque traitement a duré environ 4 minutes et coûté en moyenne 0,47 dollar.
La division par 76 ne tient pas au seul changement de modèle
Le point essentiel à retenir de ces chiffres est qu’ils ne comparent pas les performances des modèles seuls, mais les résultats obtenus en associant un modèle à un dispositif de traitement. Un agent de navigation est une IA qui lit des pages web et effectue des tâches comme la collecte d’informations ou le remplissage de formulaires. Asana propose l’automatisation de ce type de tâches grâce à StackAI, qu’elle a racheté.
Pour le test, l’équipe a recueilli six informations sur chacun de 32 livres issus d’un catalogue public de démonstration. Elle a effectué 144 essais au total avec quatre modèles et plusieurs configurations. Avec le modèle B utilisé initialement, le coût estimé des modèles dépassait 36,21 dollars par traitement, mais il est tombé à 1,24 dollar après une simple refonte du dispositif de traitement. Avec la configuration optimisée utilisant GPT‑6.1 Sol, il est même descendu à 0,47 dollar.
Autrement dit, même sans remplacer le modèle B, il a été possible de réduire les coûts à environ un vingt-neuvième de leur niveau initial. Derrière le chiffre mis en avant, une division par 76, l’amélioration de la conception du traitement avant même le choix du modèle a joué un rôle majeur.
La clé des économies : l’historique de navigation transmis à l’IA
Dans la configuration précédente, les instructions fixes étaient mises en cache, mais pas l’historique constitué au fil des pages consultées et des captures d’écran. Le cache est un mécanisme qui permet de réutiliser des données déjà traitées. Sans possibilité de réutiliser l’historique, chaque appel à l’IA renvoie les informations précédentes, ce qui entraîne des frais supplémentaires.
De plus, les anciennes images étaient supprimées et les textes raccourcis presque à chaque étape. L’historique étant fréquemment modifié, la simple mise en place d’un cache avait peu de chances d’être efficace. Supprimer trop d’informations peut aussi obliger l’agent à consulter de nouveau des pages déjà lues.
L’équipe a donc relevé de 120 000 à 480 000 caractères la limite de conservation de l’historique et a également mis celui-ci en cache. Elle a choisi de stocker jusqu’à 20 captures d’écran, puis de ne conserver que la plus récente. Au lieu de nettoyer les données à chaque fois, elle les a regroupées pour pouvoir réutiliser l’historique existant plus longtemps sans le modifier.
Conserver davantage d’informations peut aussi réduire les coûts
Moins d’informations transmises à l’IA, donc des coûts plus faibles : ce résultat montre que cette seule logique ne suffit pas à expliquer le coût des agents. Dans certains cas, conserver et réutiliser les informations tout en évitant les vérifications inutiles revient moins cher pour l’ensemble du traitement.
Avec GPT‑6.1 Sol, après avoir augmenté la limite de conservation de l’historique et optimisé le cache ainsi que la gestion des images, le coût estimé des modèles par traitement est passé de 1,97 à 0,47 dollar. Après optimisation, 89 % des données d’entrée provenaient du cache, et les frais associés représentaient 5 % de ce qu’ils auraient coûté sans cache.
Le volume d’historique a également une incidence sur la réussite des tâches. Avec GPT‑6.1 Sol, une réponse a pu être générée dans 3 des 18 exécutions lorsque la limite de conservation était basse, contre 18 sur 18 avec une limite plus élevée. Dans le cadre du test, les 18 réponses obtenues étaient correctes.
L’IA a aussi servi à tester des pistes d’amélioration
GPT‑6 Astra de Codex a été utilisé pour la recherche et l’optimisation, en complément de GPT‑6.1 Sol, qui effectuait les opérations dans le navigateur. Il a analysé la structure du code, repéré les problèmes de gestion de l’historique, remanié le code pour les essais et testé plusieurs configurations en parallèle.
Des humains sont néanmoins intervenus. Frank Hidalgo, directeur technique de StackAI, a examiné les propositions et choisi les modifications à tester. Les comptes rendus et les résultats des essais ont également été évalués lors d’autres sessions avec des modèles, puis conservés dans Command, l’environnement de développement d’Asana. Les changements ont été déployés en production après être passés par des tickets et des pull requests.
Frank Hidalgo explique qu’une étude qui aurait pris un à deux mois avec un travail manuel a été menée en environ une semaine. Cette comparaison repose sur son estimation du temps nécessaire, et non sur une expérience témoin menée par des humains seuls pour effectuer le même travail.
Pour décider d’un déploiement, il faut évaluer ensemble le coût et le taux de réussite
Le montant de 0,47 dollar correspond au coût estimé des modèles, et non au coût total incluant la main-d’œuvre et l’exploitation du système. En outre, certaines des configurations de référence ont atteint leur limite de nombre d’exécutions sans avoir terminé : les valeurs de plus de 36,21 dollars et de plus de 22,5 minutes sont donc des minimums. Les principaux chiffres comparatifs sont des moyennes calculées sur trois exécutions par configuration ; le même taux de réduction ne peut pas être appliqué à toutes les tâches web.
Parmi les configurations optimisées, le modèle C a coûté 0,66 dollar et pris 3,5 minutes, contre 0,47 dollar et environ 4 minutes pour GPT‑6.1 Sol. Pour cette tâche, Sol était moins cher, mais le modèle C était plus rapide : le classement diffère donc selon que l’on privilégie le coût ou la vitesse.
Asana a intégré ces changements à la fonctionnalité de navigation de StackAI. L’entreprise prévoit désormais d’ajouter des outils d’évaluation à la plateforme afin que les clients et les équipes internes puissent comparer, selon les configurations, le coût, le temps d’exécution et la qualité des réponses.

コメント