
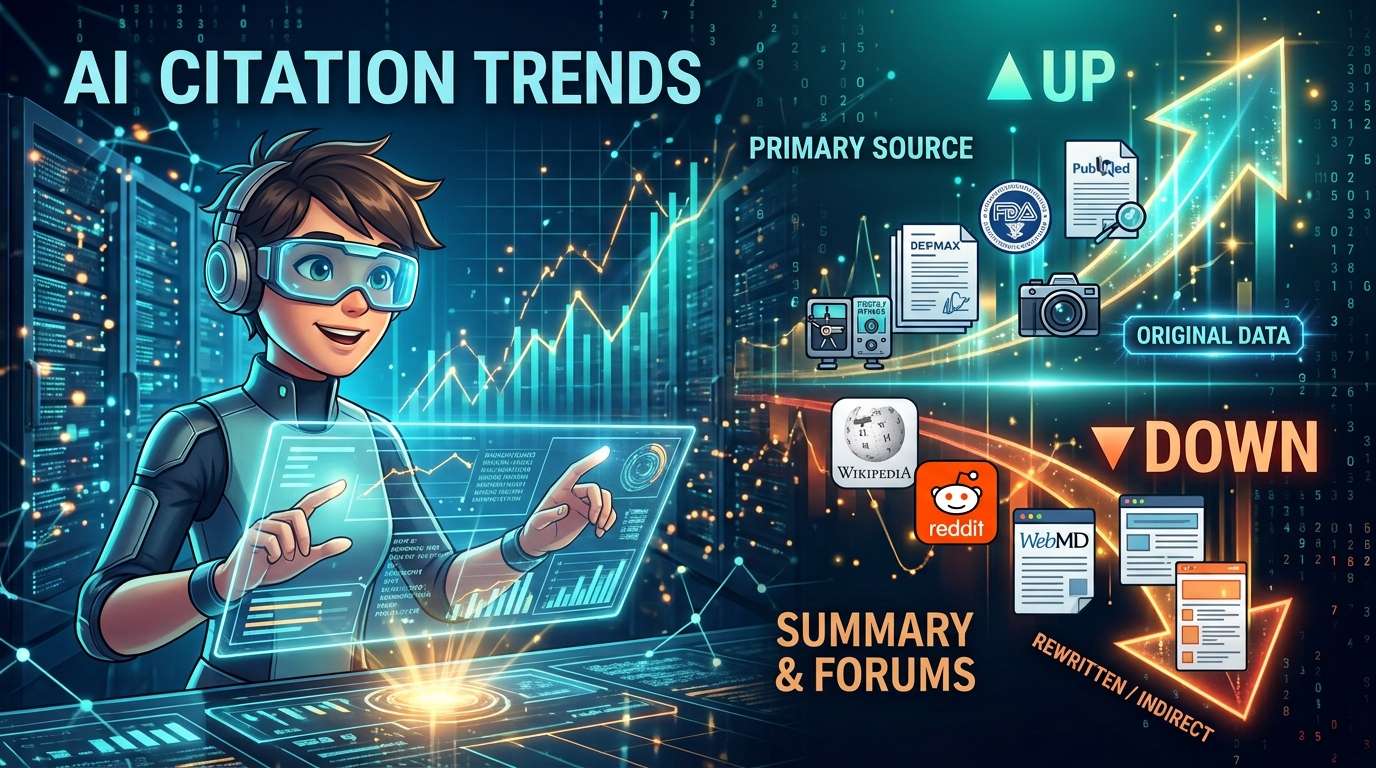
Ahrefs, spécialiste des outils SEO, a publié l’évolution du classement des domaines cités dans les réponses de ChatGPT destinées aux États-Unis. Entre mars et septembre, PubMed, la base de données d’articles médicaux, est passé de la 64e à la 4e place, tandis que WebMD, un site d’information sur la santé, a reculé de la 18e à la 79e place. Les sites disposant de sources originales, comme des données de recherche ou des tests en conditions réelles, se sont ainsi hissés en tête.
Les bases de données d’articles scientifiques progressent, les sites explicatifs reculent
L’étude porte sur les 200 domaines les plus fréquemment cités dans les réponses de ChatGPT destinées aux États-Unis. Elle s’appuie sur environ 2,4 millions de réponses en mars et quelque 3,8 millions en septembre.
Outre PubMed, les principaux gagnants sont des organismes publics de santé et de recherche, des autorités de régulation ainsi que des sites qui testent et évaluent des produits en conditions réelles. FDA et RTINGS figurent parmi les exemples cités.
À l’inverse, WebMD et Verywell Health, qui rendent les travaux de recherche plus accessibles, ainsi que des sites explicatifs dans les domaines de la santé et de la finance comme Healthline et Investopedia, ont reculé dans le classement. Britannica, Investopedia et New York Post sont sortis du top 200.
Ahrefs estime que ChatGPT semble privilégier les sources originales plutôt que les sites qui synthétisent des informations.
L’ère du « détenteur de l’information » plutôt que du « synthétiseur » ?
Les articles explicatifs sur la santé et la finance sont des domaines où les sites ont jusqu’ici excellé dans les moteurs de recherche. Ils ont joué un rôle de médiation en interprétant des articles scientifiques et des documents publics pour les reformuler dans un langage simple. Mais au moment où l’IA génère une réponse, elle prend elle-même en charge cette étape de « traduction ». Dès lors, il semble logique qu’elle préfère consulter les sources originales plutôt que ceux qui les ont reformulées.
L’essor des sites de tests de produits est un autre élément notable. Contrairement aux articles qui se contentent de réorganiser des tableaux de caractéristiques, les mesures effectuées et les impressions d’utilisation ne peuvent être publiées que par le site qui les a recueillies. Le fait de disposer d’un contenu original pourrait ainsi devenir un critère déterminant pour être cité par l’IA.
Ahrefs recommande également aux éditeurs de miser sur des pages qu’eux seuls peuvent produire. Il s’agit notamment d’études originales, de tests de produits en conditions réelles et d’informations sur leurs propres produits.
La part des citations de Reddit et Wikipédia chute nettement
La proportion de réponses destinées aux États-Unis qui citaient Reddit est passée de 19,1 % en mars à 2,3 % en septembre. Celle de Wikipédia a également diminué, de 14,1 % à 2,9 %. Ahrefs précise toutefois que les deux sites restent parmi les domaines fréquemment cités par ChatGPT.
Concernant Reddit, un autre outil d’analyse, Promptwatch, avait constaté une baisse similaire en août. La part de reddit.com dans les citations de la recherche ChatGPT serait passée d’une moyenne de 3,83 % entre la fin juillet et le début août à 0,52 % à la mi-août. Ahrefs mesure toutefois la « proportion de réponses citant Reddit » : sa méthode diffère de celle de Promptwatch.
Dans un autre échantillon portant sur l’ensemble du monde, reddit.com arrivait en 9e position parmi les domaines que ChatGPT ciblait le plus souvent avec une recherche site: (une recherche limitée à un site donné). Cela montre que Reddit conserve une présence notable dans les recherches, même après la baisse de sa part dans les citations.
Le classement des citations et le trafic sont deux choses différentes
Il faut garder à l’esprit que ce classement mesure la fréquence des citations, et non le nombre de visiteurs des sites. Un recul dans le classement ne signifie pas que le trafic du site a diminué dans les mêmes proportions. À l’inverse, figurer parmi les premiers ne signifie pas nécessairement que le site reçoit des clics et que ses contenus sont lus.
Par ailleurs, le système de suivi d’Ahrefs ajoute des questions au fil du temps. Les variations de classement peuvent donc s’expliquer par le renouvellement des questions étudiées. L’entreprise a ainsi comparé environ 25 000 questions qui figuraient parmi les 150 000 questions à fort volume à la fois en mars et en septembre. Elle indique que tous les sites du graphique ont évolué dans la même direction.
Dans la plupart des réponses, aucune recherche n’est effectuée
Une autre étude porte sur la fréquence à laquelle ChatGPT effectue des recherches sur le Web. Sur les 66,6 millions de réponses fournies en août et septembre à des utilisateurs gratuits et non connectés, 14,4 % s’accompagnaient d’une recherche sur le Web. Les données concernent le modèle GPT-5.6 Luna et couvrent toutes les régions.
Pour les réponses accompagnées d’une recherche, ChatGPT effectuait en moyenne environ 1,6 recherche en arrière-plan avant de répondre — un processus appelé « fan-out ». Sur les 15 millions de recherches fan-out, 6,8 % étaient des recherches site: limitées à un site donné et portaient sur 116 000 domaines. Parmi les quelque 160 domaines les plus recherchés, 75,9 % correspondaient à des sites officiels d’entreprises comme Apple ou Ikea.
Un autre cabinet d’études, Nectiv, a soumis environ 4 000 questions à GPT-5.6 Sol via l’API et constaté une moyenne de 7,61 recherches fan-out par question. Les modèles, les questions et les méthodes de collecte étant différents, il n’est toutefois pas possible de comparer directement ce chiffre aux 1,6 recherche. Ahrefs indique aussi que les utilisateurs gratuits et non connectés effectuent moins de recherches que les utilisateurs de modèles payants ou de modèles de raisonnement, ce qui contribue à l’écart.
Ce que les éditeurs de sites voudront vérifier
Les chiffres d’Ahrefs correspondent à un instantané d’un seul modèle, recueilli entre août et septembre. L’entreprise souligne également que les tendances pourraient évoluer avec les futures mises à jour du modèle.
Pour les éditeurs, la démarche la plus concrète consiste donc à vérifier régulièrement quelles pages ChatGPT cite sur leurs principaux thèmes, et quelles sources sont choisies à leur place. Si les articles explicatifs constituent leur principal levier d’acquisition de trafic, il vaut la peine de refaire le point à chaque mise à jour des modèles d’OpenAI.








コメント